你有没有遇到过这种同学:平时考试成绩特别好,但你稍微换个问法他就懵了?
这不是段子,这是最近一批研究者在测试AI编程能力时真实撞见的现象。而且这次撞上的不是某个无名小卒,是当下最主流的代码评测标杆,SWE-bench。
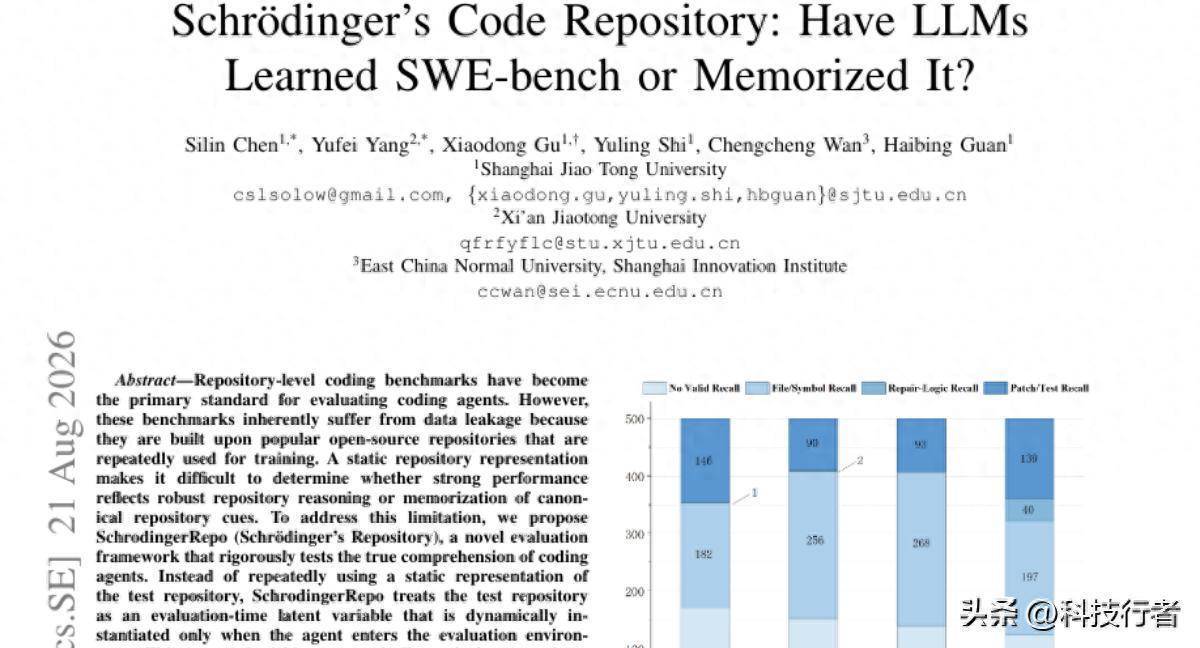
先说个可能颠覆你认知的事实。你可能以为,AI在SWE-bench上拿到70%甚至更高的分数,说明它已经具备了相当靠谱的软件工程能力,能真的看懂一个陌生代码库,找到bug,然后修好它。但上海交通大学等机构的研究者们做了一个实验后发现,事情没那么简单。他们让人类专家像挤牙膏一样,一点点地给AI透露某个SWE-bench任务的线索,从最模糊的描述开始,逐步给出更具体的信息。结果呢?
在四个测试模型里,每个模型都有超过65%的任务,在几乎还没看到任何仓库文件、没看到正确答案、没看到测试代码之前,就已经开始"回忆"起了具体的修复逻辑,甚至直接说出补丁的内容。这不是推理出来的,这是背出来的。
这件事听起来有点尴尬,但仔细想想也不奇怪。
问题出在哪儿
SWE-bench这个评测集,取材自Django、requests这类超级知名的开源项目。这些项目的代码、issue讨论、修复记录,早就散落在互联网的各个角落,很可能已经被塞进了各种大模型的训练数据里。
这就好比一场"公开题库"的考试。如果你知道某场考试的题目和答案早就被泄露到了培训机构的资料库里,那这场考试还能不能用来判断学生是真的学会了知识,还是背下了答案?显然不能,因为你无法区分这两种情况。如果不做任何处理,继续沿用这套题库来打分,你测出来的高分可能根本不是能力,只是记忆力。
之前也有团队尝试过修补这个漏洞,比如SWE-bench Live和SWE-rebench,它们的思路是不断往里加新题,专挑模型发布之后才出现的issue,这样就能保证模型没提前见过。这个思路没错,但有个先天短板:新题目的数量和多样性,永远追不上那些经年累月积累下来的经典老项目里包罗万象的bug类型。
那怎么办?把老题目重新出一遍,但换个"马甲"。
这就是这篇论文的核心思路,研究者管它叫SchrodingerRepo(薛定谔的代码仓库)。
代码仓库的"薛定谔态"
这个名字取得挺有意思,借用了那只著名的既死又活的猫。核心思想是:同一个任务的代码仓库,不再是一份固定不变的"标准答案版本",而是变成一个只有在AI真正打开评测环境的那一刻,才会被随机生成出来的具体样子。
换句话说,AI每次进考场,看到的都是同一道题的不同"变装版"。
引用块:SchrodingerRepo:一种评测框架,它不直接复用SWE-bench原本固定的代码仓库展示形式,而是在评测运行时动态生成一个语义完全等价、但表面特征被打乱的仓库版本,用来检测AI是不是靠"认出"仓库表面特征来蒙对答案的。
这套框架具体分成四个变形层级,一层比一层狠。
第一层是问题描述重写。用两阶段的LLM流程,先把issue的原始描述换一种说法重新表述,再用另一个模型检查有没有把关键约束漏掉或改错,如果漏了就打回去补上。这一层动的只是文字表面,不动代码本身。
第二层叫命名空间映射,这是四层里最狠的一层,后面会详细说。
第三层是文件内部布局重排。同一个文件里,函数和类的定义顺序被打乱重排,但保证代码逻辑不受影响。
第四层是功能保持的代码重写,把和bug直接相关的代码段用完全不同的写法重新实现一遍,但功能不变。
这四层可以单独测,也可以叠加一起测,用来观察到底是哪一层的"伪装"最能戳中AI的软肋。
命名空间映射:把熟悉的名字全换掉
这一层最值得展开讲讲,因为效果最猛。
它做的事情说白了就是给整个代码仓库里所有"仓库自己起的名字
天顺优配提示:文章来自网络,不代表本站观点。